中国AI大模型正在全球“霸榜”
“ 从“14周”到“24周”:中国AI大模型凭什么在全球调用榜上长期霸榜 央视说“连续14周霸榜”,南方财经口径已经是“连续24周”;8月的周榜是“前五占四席”,10月的周榜干脆前五全是中国模型。同一个榜单、不同的时间切片,指向同一个事实:全球 ”
从“14周”到“24周”:中国AI大模型凭什么在全球调用榜上长期霸榜
央视说“连续14周霸榜”,南方财经口径已经是“连续24周”;8月的周榜是“前五占四席”,10月的周榜干脆前五全是中国模型。同一个榜单、不同的时间切片,指向同一个事实:全球开发者正在用Token为中国大模型投票。但调用量领先,究竟等于多少商业价值?
🏆 先把事实摆清:谁在霸榜,霸了多久
这轮讨论的起点,是全球多模型聚合平台 OpenRouter 的调用量(Token)榜单——它统计的是全球开发者在真实场景中调用各家模型的实际消耗,被认为是衡量“使用强度与应用广度”的硬指标,而非跑分。
据央视新闻报道,截至2026年8月初的最新一周,AI大模型调用量榜单排名前五的产品中,中国占四席,中国AI已连续14周“霸榜”全球。而两个月后,据南方财经类媒体报道的OpenRouter数据,10月5日至10月11日这一周,全球AI大模型总调用量达172万亿Token,其中中国模型贡献86.74万亿Token,是同期美国(18.97万亿)的约4.5倍,周调用量已连续24周超过美国,当周全球前五名全部为中国模型。
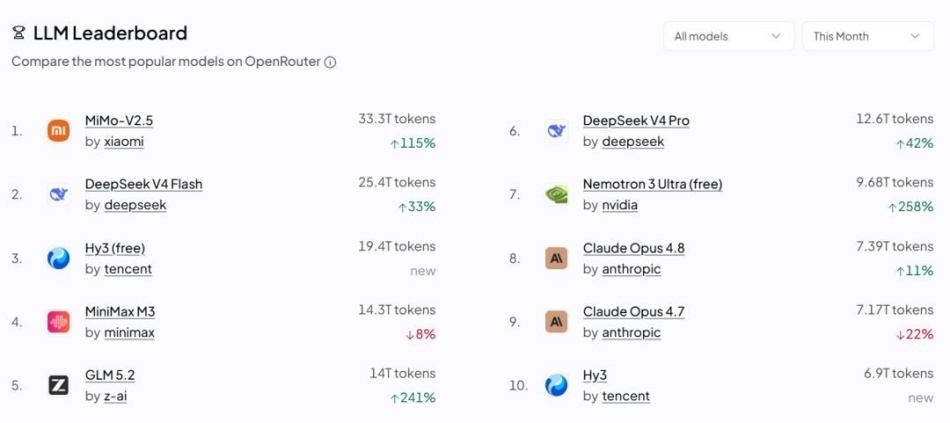
两组数据并不矛盾,只是时间切片不同:从“14周”到“24周”,中国模型的领先没有被打断,反而在榜单密度上进一步抬升——8月还是“前五占四”,10月已是“前五包揽”。更早的2026年7月,OpenRouter月度调用量排行榜的前六名也全部为中国自研开源模型,依次为小米MiMo-V2.5、DeepSeek V4 Flash、腾讯HY3、MiniMax M3、智谱GLM-5.2、DeepSeek V4 Pro。
🔧 机制拆解:开源铺管道,性价比换调用量
霸榜的直接原因并不玄妙,一句话概括:闭源模型卖的是门票,开源模型铺的是管道。
权重一旦开放,全球开发者和企业就能在自己的场景里部署、微调、集成;生态长起来,调用量自然水涨船高。据央视财经数据,中国开源模型下载量已占全球总量的41%,位居世界第一。这形成了一个可自我强化的循环:
- 开源开放 → 开发者低成本接入,生态扩张;
- 生态扩张 → 调用量上升,暴露更多真实场景需求;
- 需求反馈 → 迭代优化加速,模型更好用;
- 更好用 + 更便宜 → 吸引更多开发者回到第一步。
价格是最直接的杠杆。OpenRouter负责数据与分析的贾斯汀·萨默维尔在接受CNBC采访时透露,中国开源大模型的价格相较Anthropic、OpenAI的头部模型普遍低60%至90%。OpenRouter上的主力用户是全球开发者与中小创业团队,对成本极度敏感,用脚投票的结果就是调用量集中流向中国模型。
📊 价格与能力:一张表看清“性价比红利”
据美国研究公司Artificial Analysis公布的数据(截至10月17日),取中美两方定价较高的代表模型对比,差距一目了然:
| 模型 | 归属 | 每百万Token输入价 | 每百万Token输出价 | 平均单任务成本 |
|---|---|---|---|---|
| Kimi K3 | 月之暗面(中国) | 3美元 | 15美元 | 约2美元 |
| Claude Fable 5.1 | Anthropic(美国) | 10美元 | 50美元 | 约7.63美元 |
| DeepSeek V4.1 Flash | 深度求索(中国) | 未披露具体数值(Claude为其数十倍) | 未披露具体数值 | 不足Claude的1/28 |
换算下来,Claude Fable 5.1的输入、输出价格均为Kimi K3的3.3倍,单任务成本达3.8倍——花同样的钱,用Kimi K3能跑近4个任务。
价格之外,能力差距也在收窄。美国斯坦福大学今年发布的《2026年AI指数报告》显示,自2025年初以来,中美两国模型已多次交替登顶性能榜单;截至2026年3月,美国顶尖模型与中国顶尖模型的差距仅有2.7%。英特尔CEO陈立武公开表示,DeepSeek、Kimi和GLM等中国前沿模型不仅使用成本较低,性能也已“足够好”,市场采用速度“非常快”。黄仁勋则多次称赞中国开源模型“非常优秀”,认为其降低了AI使用门槛、将扩大整体市场规模。
一个颇具说服力的细节是:开源社区Hugging Face此前遭到OpenAI模型的自主攻击,官方在复盘中明确表示,在求助闭源模型失败后,是通过部署开源的智谱GLM-5.2才完成整个取证分析流程。这说明中国开源模型已不只是“便宜能用”,在高难度、高可信度场景下也能扛住任务。
🌍 溢出效应:从东南亚小语种到流媒体剧组
调用量背后是真实的落地版图。在东南亚,语言多达1200余种、日常交流多语混用,而西方主流模型的预训练数据中80%以上是标准英语,东南亚语言内容占比一度只有0.5%,导致不少“美式”模型水土不服。中国模型在预训练阶段就覆盖当地上百种语言——从新加坡国家级“海狮”模型全面转向阿里通义千问基座,到马来西亚政府服务能力建设,都是这一逻辑的延伸。
在欧美,中国模型成了降本工具。据英国《金融时报》报道,美国外卖巨头DoorDash、全球旅行房屋租赁平台爱彼迎和德国科技巨头西门子等大型企业纷纷转向中国人工智能模型;据美国投资机构数据,多达80%的美国AI初创公司在融资路演时会使用中国的开源模型。在非洲,开发者把中国开源模型当作本地创新的“工具箱”,用自有数据做定制化服务。在影视行业,美国流媒体平台亚马逊热播剧《大卫王朝》第一季共包含72个运用AI技术的镜头,其中视频生成部分由国产模型可灵AI参与,主创称原本需要4至5个月的工作量被压缩到几周。
工程成熟度也在被验证:小米MiMo-V2.5两个月调用量增长约616%;月之暗面Kimi K3以2.8万亿参数成为全球最大开源模型,上线两天即被挤爆。
⚠️ 冷静面:Token调用量不等于商业护城河
支撑这轮起势的,是“企业冲锋—政策托底—基础研究夯基”的三层结构:小米、DeepSeek、腾讯、智谱、MiniMax等持续迭代模型;从2025年国务院“人工智能+”行动意见,到2026年政府工作报告首提“打造智能经济新形态”,再到7月30日高层会议再度强调,政策信号持续加码;智谱收购中科加禾补强底层算力软件栈,则是企业夯实长期技术根基的缩影。
但必须清醒:榜单领先只是突围的信号枪,不是庆功的香槟。
- Token调用量≠深度商业绑定。高Token中相当一部分是低价批量任务,客单价偏低;而高端政企订单、To C爆款产品、专业创作领域,欧美厂商仍握有稳固基本盘。
- 优势集中在高吞吐、性价比赛道,不能简单解读为全面超越GPT、Claude。
- 短板依然存在:基础研究、算力供给、工程落地仍需持续补课。
- 榜单口径需分开看:跑分与调用量反映的是渗透广度,与营收结构、高端能力领先是两回事。
🔭 结语:把“调用量”变成“不可替代性”
从14周到24周,中国大模型确实完成了一次全球开发者生态的实质性嵌入:开源飞轮转起来了,能力跨过了“好用”门槛,全球用户用真金白银投了票。但真正的考验在下一程——能否把海量调用转化为深度产业绑定,从批量任务工具进阶到高价值商业场景;能否在基础研究与算力自主上持续突破,让AI真正沉入实体经济的每一个环节。方向已经对了,路还很长。
📚 参考来源